- Evento:
- M15 - Inference engines
- Lingua:
- Italiano
Allegati
Speaker
-
Daniele Zonca
Distinguished Engineer - Red Hat
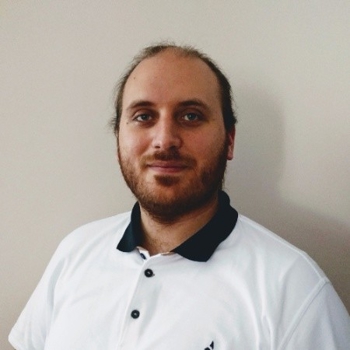
vLLM 101: Architettura, Sfide e Scaling
L'architettura Transformer è alla base di tutti gli attuali Large Language Model, ma la loro esecuzione efficiente su larga scala rimane una sfida aperta che coinvolge l'intero stack: hardware, networking, memoria e software. In questo talk parleremo di vLLM, l'inference engine open-source diventato lo standard de facto per il serving di LLM ad alte prestazioni. Ripercorreremo l'evoluzione del progetto, da ricerca accademica a soluzione enterprise, analizzando come l'intuizione di PagedAttention abbia rivoluzionato la gestione della KV Cache e l'ottimizzazione dell'uso delle GPU.
Il progetto si è evoluto rapidamente per stare al passo con le nuove architetture dei modelli: dalle strategie di parallelismo multi-nodo e multi-GPU fino ai paradigm più recenti come il disaggregated serving. Concluderemo questo percorso analizzando le sfide attuali e la direzione futura dell'infrastruttura d'inferenza.